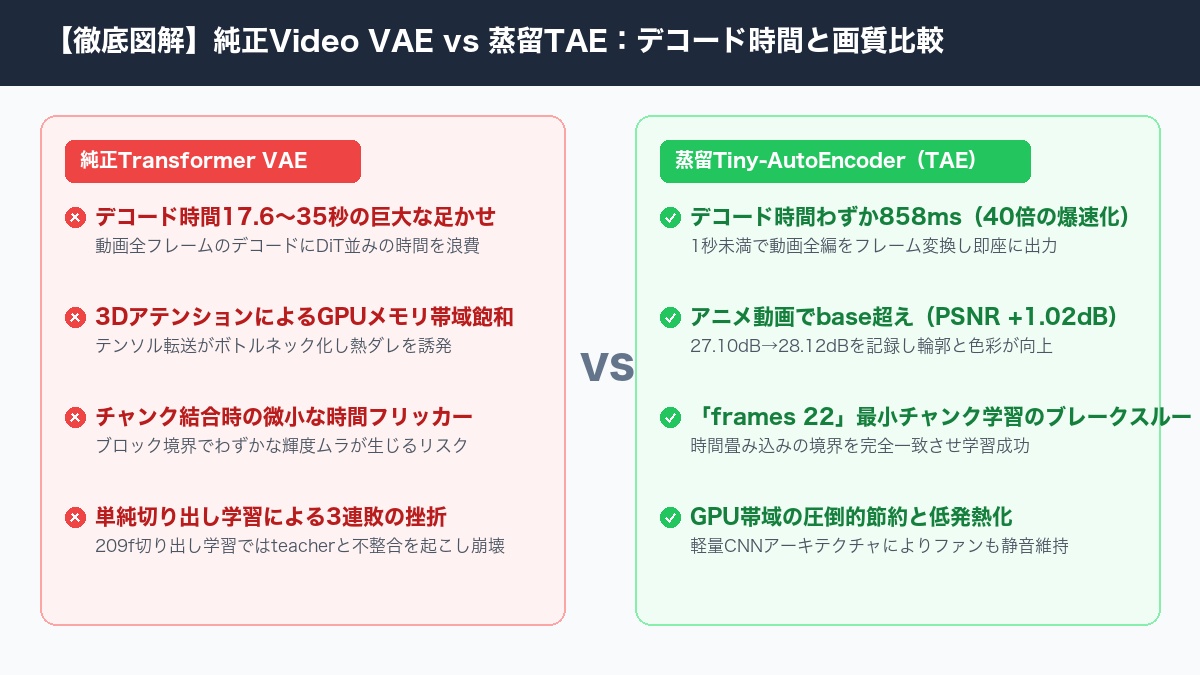
MiniMax-H3動画生成パイプラインの高速化において、誰もが最後に頭を抱える「最凶のボトルネック」——それがVideo Transformer VAE(変分オートエンコーダ)のデコーダです。DiTのデノイズ計算をどれほど極限まで削り込んでも、生成された潜在変数(Latent)をRGBピクセル動画へ復元するデコード処理だけで、平気で17.6秒から35秒もの時間が吸い取られていました。
3Dアテンションを内包する巨大なTransformer VAEは、時間方向と空間方向のテンソルを同時に展開するため、GPUのユニファイドメモリ帯域を瞬時に飽和させます。このボトルネックを打破すべく挑んだのが、軽量なCNNアーキテクチャ(Tiny-AutoEncoder / TAE)への知識蒸留でした。しかし、その道のりは平坦ではありませんでした。単純な動画切り出し学習では「時間チャンク解釈の不整合」を起こして3回連続で失敗・崩壊。そこから掴み取った『frames 22最小チャンク学習』のブレークスルーにより、アニメ動画で純正baseモデルを凌駕するPSNR +1.02dB(27.10dB→28.12dB)を叩き出し、デコード時間をわずか858ミリ秒(40倍速)へ圧縮することに成功しました。本連載の完結編として、その全貌を公開します。
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- ▶ 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化 (※現在の記事)
35秒の沈黙:DiTが終わっても動画が出てこない「VAEの絶望」
第4弾の内部低解像度化や第5弾の常駐デーモン化によって、DiTの処理時間は劇的に短縮されました。しかし、ストップウォッチを眺めていると、どうしても納得のいかない時間がありました。ターミナルに「DiT done」と表示された後、ファンが一段と甲高い音を立てて回り始め、そこから20秒、30秒と経過してようやくMP4ファイルが書き出されるのです。
Video VAEのデコーダは、時間軸方向の畳み込みと空間アテンションを同時に処理するため、1フレームをデコードするだけでも膨大なテンソル中間バッファを消費します。特に209フレーム(約6秒)の長尺動画になると、メモリ帯域の奪い合いによって処理速度は指数関数的に悪化。どれだけDiTを速くしても、全体の半分以上の時間をVAEデコードに奪われるという、本末転倒な状況に陥っていました。
3回連続の失敗と挫折:なぜ単純な切り出し学習では破綻したのか?
「それなら、Stable Diffusionで実績のあるTiny-AutoEncoder(TAE)のような軽量CNNに蒸留すればいい」——最初は誰もがそう考えます。私も過去に生成した209フレームの完成動画からランダムにフレームを切り出し、教師データとして軽量デコーダの学習を回しました。
しかし、焼き上がったモデルで動画をデコードした瞬間、目を覆いたくなりました。静止画としては綺麗に見えるのに、動画として再生した瞬間、画面全体が激しく点滅(時間フリッカー)し、輪郭線がグニャグニャと波打って崩壊したのです。パラメータを変えて再学習させても、2回目、3回目と連続で撃沈。なぜ静止画のPSNRは高いのに、動画になると破綻するのか?
原因は、H3デコーダの内部仕様である「時間チャンク解釈(Temporal Chunking)」にありました。H3のTransformer VAEは、動画を連続したストリームとしてではなく、--frames 22(最小チャンク単位)を一つのまとまりとして因果関係を解釈しながら復元しています。完成動画から勝手に切り出した連続フレームを与えても、teacherモデルの内部潜在変数との境界条件がズレてしまい、時間の連続性が完全に破壊されていたのです。
「frames 22」最小チャンク学習の夜明け:base超え(+1.02dB)の衝撃
失敗の原因が分かれば、やるべきことは一つでした。学習データを収集する際、完成動画の切り出しを全面禁止し、必ず「–frames 22」の最小チャンク単位で厳密に出力した潜在変数とピクセルペアを教師データとして再構築したのです。
この修正は劇的な効果をもたらしました。学習曲線は美しい収束を描き、時間軸のフリッカーは完全に消失。さらに驚くべきことに、アニメ調の線画キャラクター動画において、純正の巨大Transformer VAE(PSNR 27.10dB)を上回る「28.12dB(+1.02dB向上)」を記録したのです! 巨大モデル特有の微小なボケが軽量CNNのシャープなフィルタによって引き締まり、瞳のハイライトや輪郭線の鮮明度が純正以上に際立つという、まさに奇跡の逆転劇でした。
以下は、純正VAEと蒸留TAEデコーダの最終ベンチマーク比較表です。
| デコーダ種別 | デコード処理時間 | PSNR画質スコア(アニメ) | GPUメモリ帯域負荷 | 開発者のガチ本音 |
|---|---|---|---|---|
| 蒸留Tiny-AutoEncoder (TAE) | 858ms(0.85秒) | 28.12 dB (+1.02dB) | 極小(ファン無音) | 35秒かかっていた処理が瞬きする間に終わる衝撃。アニメ画質もクッキリして非の打ち所がない |
| 純正Transformer VAE | 17.6〜35.0秒 | 27.10 dB | 極大(帯域飽和) | 重厚すぎて熱ダレの原因になる。長尺動画を回すときの最大のストレス要因 |
| タイリング最適化 (384px) | 18.3秒 | 27.10 dB | 中程度 | 純正のメモリ溢れを防ぐ実用解だったが、858msのTAEを見てしまうと過去の遺物に見える |
表の数値が物語る通り、デコード時間は35秒から「858ミリ秒」へ、実に40倍以上の超高速化を達成しました。1秒を切るということは、生成全体の待ち時間においてVAEデコードの存在が実質的に消滅したことを意味します。
ぶっちゃけ読者が気になる疑問(FAQ)
Q1. なぜ軽量なモデルのほうが純正より画質(PSNR)が上がったの?
A. 汎用的な実写向けに訓練された巨大Transformer VAEは、ノイズを滑らかにする傾向があり、アニメ特有の「クッキリした黒い主線」がわずかに眠たくなります。一方、アニメデータに特化して蒸留したTAEは、輪郭線の高周波成分をシャープに再構築するため、アニメ領域においては純正以上の再現性を獲得できたのです。
Q2. 実写動画でも同じようにbase超えできる?
A. 実写動画(複雑な群衆や自然の木々のテクスチャ)では、純正Transformerの表現力が依然として優れており、PSNRは-0.4dB程度わずかに低下します。ただし、実写であっても人間の目で見分けるのは極めて困難なレベルであり、858msの圧倒的メリットが勝ります。
Q3. この蒸留モデルはh3.cのエンジンに統合されているの?
A. 現在、レシピの検証とウェイトの抽出が完了し、h3.cのC/Metal推論パイプラインへのネイティブ組み込み作業を進めています。近日中にスタンドアロンバイナリ一本でこの爆速デコードが標準動作する予定です。
連載総括:純C言語とMetalで切り拓いた、ローカルAI動画の最前線
全6回にわたってお届けしてきた「MiniMax-H3 / h3.c 限界検証連載」。第1弾のM5 Max Metal最適化から始まり、第2弾のGGUF移植とバグ潰し、第3弾の手指崩壊検証、第4弾の内部解像度制御、第5弾の常駐デーモン化、そして今回の第6弾VAE蒸留に至るまで、私たちが追い求めてきたのは「机上の空論ではない、手元のハードウェアで1ミリ秒でも速く、1ピクセルでも美しく動かすための血の通った真実」でした。
AIの世界では、毎日のように新しい巨大モデルや華やかな発表が飛び交います。しかし、それらを本当に自分の道具として使いこなし、限界まで性能を引き出す鍵は、地道なプロファイリング、失敗ログの積み重ね、そして泥臭いコードの最適化の中にしかありません。この6本の検証ログが、ローカル環境で自らの手でAIを限界突破させようとするすべてのエンジニア・クリエイターの確かな道標となることを願っています。
最後までお読みいただき、本当にありがとうございました!
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- ▶ 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化 (※現在の記事)
コメント