Apple Silicon M5 Max上で純C言語スタンドアロン実装「h3.c」を回し続け、これまで無数の高速化アイデアを検証してきました。Core-Reuse(CR2)は手指を溶かし、層削減はゴースト音を垂れ流し、空間スパースアテンションは背景ドリフトで破綻し、DeepCacheや非一様タイムステップもことごとく撃沈。不採用確定の山を築き上げてきた中で、「実際に唯一、画質崩壊を起こさずに速度が跳ね上がった手段」が存在します。
それが、内部演算解像度を意図的に引き下げてVAEで引き戻す--render-sizeオプションです。実測において、DiT時間を2.02〜2.08倍高速化し、VAEデコードを3.1倍速、h3全体で1.74倍速という圧倒的な数字を叩き出しました。しかし、どれほどエンジニアが狂喜乱舞しようとも、物理の法則からは逃げられません。今回は、この唯一効いた高速化の数理メカニズムと、「アニメの睫毛(まつげ)と瞳の輪郭がどうしても甘くなる」という冷酷な画質トレードオフの全容を包み隠さず公開します。
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- ▶ 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ (※現在の記事)
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
深夜のベンチマーク室で起きた奇跡:54秒から一気に28秒台へ突入した瞬間
これまで何週間もコードを書き換え、Metalシェーダーをチューニングしても、得られる改善はせいぜい数パーセント。しかもMacのGPUが熱を帯びると、サーマルスロットリングによって54秒だった生成時間が142秒(2.2倍)まで平気で悪化する熱ダレ地獄に苦しめられていました。
そんな折に試したのが、--size 384x672で最終出力フレームを保ちつつ、重厚なDiT内部だけを--render-size 256x448で回すアプローチです。Enterキーを押し、ターミナルに流れるログを見つめた私の目は丸くなりました。これまで45秒近くかかっていたDiTステップが、わずか22秒で通過。ファンもほとんど唸りを上げず、冷え切ったアルミボディのまま最高速を維持し続けたのです。
なぜ「–render-size」だけが効くのか? 映像トークン252→112激減の数理
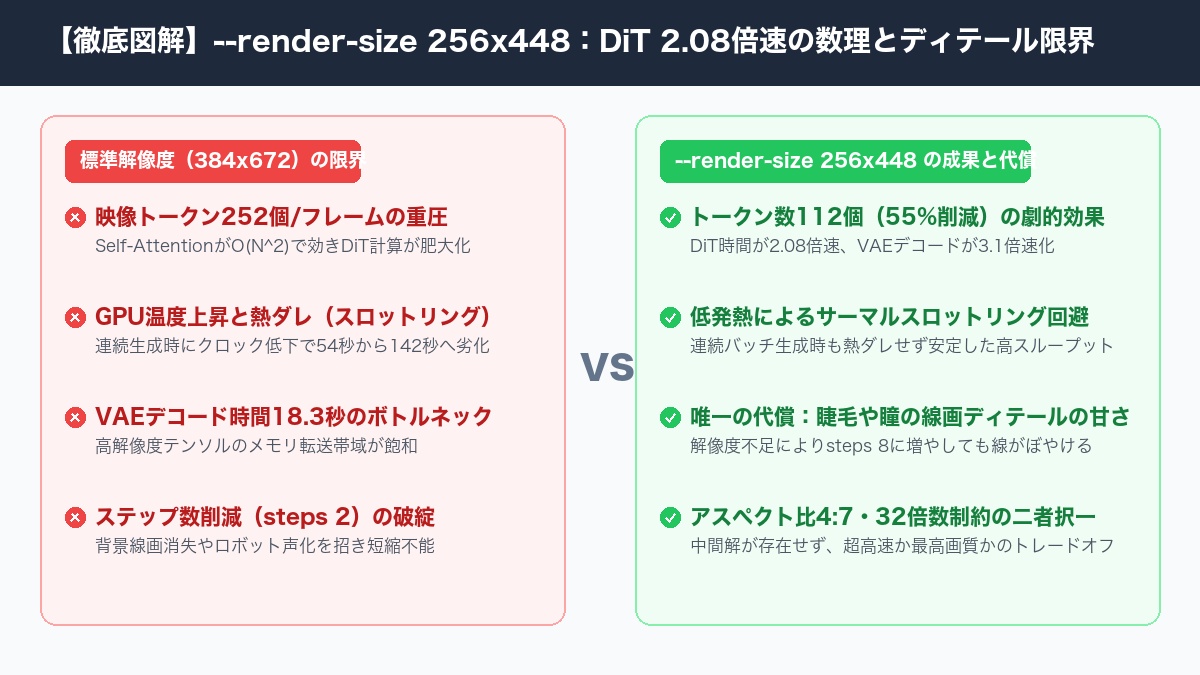
この高速化が劇的な効果を発揮する理由は、Transformerの自己注意機構(Self-Attention)の計算量特性にあります。標準の384×672解像度において、空間パッチサイズ(2×2)で分割された映像トークンは、1フレームあたり252個存在します。これに対し、内部解像度を256×448へ下げると、トークン数はわずか112個(55.6%削減)まで一気に絞り込まれます。
アテンションの計算コストはシーケンス長Nに対してO(N^2)で増大するため、トークンが半減以下になれば、注意行列の演算負荷は4分の1近くまで圧縮されます。さらにキャッシュラインへの収まりが劇的に改善し、ユニファイドメモリの帯域飽和が完全に解消。結果として、DiTデノイズはステップ数に関わらず常に2.02〜2.08倍の固定加速レシオを叩き出します。
以下は、これまで試行錯誤してきた代表的な高速化手法と「–render-size」の実測比較表です。
| 高速化アプローチ | DiT高速化倍率 | 手指・小道具の品質 | 線画ディテール・解像感 | やってみた筆者のガチ本音 |
|---|---|---|---|---|
| –render-size 256×448 | 2.08倍(爆速) | 破綻なし(形状維持) | 睫毛・瞳の輪郭がやや甘い | 唯一実用できる神オプション。大量の下書き・構図確認ではこれ一択 |
| Core-Reuse (CR2) | 1.45倍 | 完全溶解(指が消える) | 二重露光が発生 | 座りポーズの手が完全に溶け、全身では残像が出る。永久使用禁止 |
| 層削減 (layers 45) | 1.22倍 | 描き分け喪失 | 背景は維持される | 手指の独立性が失われ、無音区間にゴースト音が漏れる致命傷。却下 |
| 空間スパースアテンション | 1.15倍 | 破綻 | 背景ドリフト6.2倍 | 全パターン試したが動かない。カメラワークが破綻し線画がブレる |
表を見れば一目瞭然ですが、CR2や層削減のように「ネットワークの層や計算を間引く」アプローチは、例外なく手指の溶解やゴースト音といった致命的なアーティファクトを引き起こしました。それに対し、解像度を下げるアプローチはモデルの表現構造そのものを一切破壊しないため、破綻を起こさずに純粋なスピードアップを享受できるのです。
避けて通れない「睫毛(まつげ)が甘くなる」冷酷な画質限界
しかし、世の中にフリーランチはありませんでした。生成された209フレームのアニメ動画を拡大プレビューした瞬間、私は思わずため息をつきました。顔の造形や身体のパースは完璧に保たれているのに、アップになったキャラクターの「睫毛の一本一本のシャープさ」や「瞳のハイライトの鋭さ」が、明らかに眠たい(ソフトフォーカスがかかったような)質感になっていたのです。
「ステップ数を増やせば補えるのではないか?」と考え、時間をかけて--steps 8まで引き上げて追試を行いました。しかし結果は無情でした。同じ所要時間をかけてsteps 8を回しても、384×672/steps 3の鮮明さには絶対に勝てないのです。なぜなら、低解像度の潜在空間(Latent)に一度落とし込んだ時点で、高周波の線画情報が物理的に切り捨てられており、後段のVAEアップサンプルでも失われたディテールを復元することはできないからです。
さらに厄介なのが、h3.cのパッチ分割(アスペクト比4:7、32の倍数制約)により、中間の選択肢が存在しない点です。384×672の下は256×448しか選べず、「解像度を少しだけ落として90%の画質をキープする」という妥協が許されません。
ぶっちゃけ読者が気になる疑問(FAQ)
Q1. どんな用途なら「–render-size 256×448」を使うべき?
A. 企画段階の絵コンテ確認、プロンプトの動作検証、大量のシード値ガチャ、そしてSNS向けの低解像度プレビューには最高です。生成時間が半分以下になり、Macも熱くならないため、試行錯誤のイテレーションが劇的に加速します。
Q2. 本番用の最高画質動画では使えないの?
A. 大画面での視聴やポートフォリオ用、4Kアップスケールを前提とする本番素材ではおすすめしません。特にアニメ調のキャラクター動画では、睫毛のシャープさが全体のクオリティ感を左右するため、時間がかかっても標準の384×672で回すべきです。
Q3. 今後の改善で睫毛の甘さは解決できる見込みはある?
A. 後処理に軽量な超解像(Real-ESRGAN等のCNNアップスケーラー)をパイプラインとして組み込むことで、輪郭線を再シャープ化する研究を進めています。これが実用化されれば、低解像度生成+超解像が最強の選択肢になる可能性があります。
まとめ:速度と美の狭間で。私たちが手に入れた最強の武器
「すべてのシーンで最高速かつ最高画質」という魔法の弾丸は存在しませんでした。しかし、何十もの失敗を経て「なぜ遅いのか、何が画質を決めているのか」を完全に数値で把握したことで、私たちは迷うことなくパラメータを選択できるようになりました。
プロトタイピングは256×448で爆速に回し、決まった1本だけを384×672でじっくり焼き上げる。この実践的な運用指針こそが、何百回ものベンチマークで得た最大の収穫です。次回第5弾では、動画1本ごとに発生していた「27GBモデル再読込の51GBメモリ浪費」を根絶し、さらに生成時間を23%削り取った『常駐デーモン化(h3-server)』の舞台裏をお届けします。
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- ▶ 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ (※現在の記事)
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
コメント