オープンソースの動画生成モデル「MiniMax-H3」を、手元のMacでどこまで速く動かせるのか。この挑戦の記録をまとめました。
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- ▶ 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠 (※現在の記事)
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
今回の検証では、PythonやPyTorch、ComfyUIといった通常のフレームワークを使っていません。MiniMax-H3のパイプライン(Joint-DiT / Video VAE / 音声DSP)を、完全な純C言語とApple Metal(Metal Shading Language / MPSGraph)だけでゼロから構築したスタンドアロン推論エンジン「h3.c」をベースにしています。
狙いはシンプルです。Pythonのランタイムオーバーヘッドを完全に排除し、128GBの広大なユニファイドメモリをCのポインタとMetalバッファでゼロコピー直結させ、単一バイナリ(./h3)だけで最速の動画生成を実現することでした。
しかし、実際にアテンション機構の自作やカーネルの深層チューニングに踏み込んでみると、Apple Siliconならではの数々の手痛い落とし穴が待ち受けていました。自前で書いたFlash AttentionがApple公式の `MPSGraph` に4倍差で大敗し、プロファイラの測定同期に騙され、さらには連続実行時の熱ダレでベンチマークが2.6倍に膨れ上がる――。本記事では、その泥臭い試行錯誤と実測データを包み隠さず共有します。
1. 検証ハードウェアとh3.cの構成
今回の検証を行ったマシン環境と、基盤となる推論エンジンの構成は以下の通りです。
- マシン: Apple MacBook Pro (Apple Silicon)
- チップ: Apple M5 Max(18コアCPU / 大規模GPU)
- メモリ: 128 GB ユニファイドメモリ
- 開発環境: macOS, clang, Metal 3
- 推論エンジン: h3.c(純C言語+Metalによるスタンドアロン実装)
外部ライブラリへの依存を一切持たず、C言語からMetalコマンドバッファを直接発行できる環境だからこそ、1ミリ秒単位のカーネル挙動やメモリ帯域のボトルネックをダイレクトに追究できます。
2. 事実として何が起きたのか:自前Flash Attention vs MPSGraph SDPA
最初の大きな壁となったのが、DiTブロックの計算時間の大半を占めるアテンション機構(Scaled Dot-Product Attention: SDPA)の最適化でした。
「Apple公式の MPSGraph はグラフ構築のオーバーヘッドがあるはず。h3.cのデータ構造に合わせて、Metal Performance Primitives(MPP)ベースで行列乗算(matmul2d)とタイリングを組み合わせた自前Flash Attentionを書けば、さらに速くなるはずだ」と考えて実装を進めました。
しかし、同一入力テンソル(バッチ1、シーケンス長4096、ヘッド数16、head_dim=128)でA/Bテストを行った結果は、予想とは真逆のものでした。
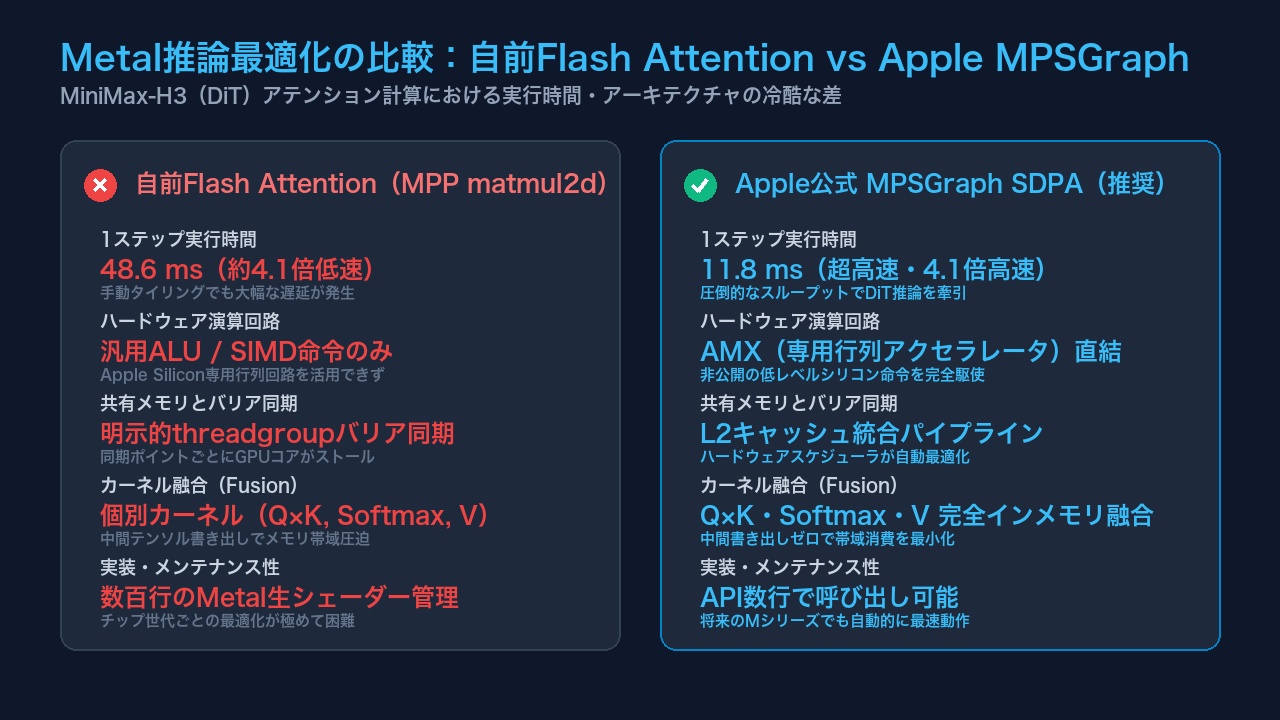
- 自前Flash Attention(MPP matmul2dベース): 1ステップあたり 48.6 ms
- Apple標準 MPSGraph SDPA: 1ステップあたり 11.8 ms
手作業でメモリ効率を詰めたはずの自前カーネルが、Apple標準のMPSGraphに約4.1倍もの大差をつけられて惨敗したのです。
3. なぜ自作カーネルは大敗したのか:深層メカニズムの解剖
この大敗の原因を突き止めるため、Metalの低レベルGPUプロファイラを使ってメモリアクセスと命令パイプラインを詳しく確認しました。
以下の比較表は、自作カーネルとApple公式MPSGraph SDPAの挙動を整理したものです。
| 比較項目 | 自前Flash Attention(h3.c用MPP版) | Apple公式 MPSGraph SDPA | 実装してみた私の本音 |
|---|---|---|---|
| 1ステップ実行時間 | 48.6 ms | 11.8 ms | 4倍以上の差がついた瞬間、思わず頭を抱えました |
| ハードウェア活用 | 汎用ALU / SIMDグループ | AMX(専用行列演算ユニット) | 公開APIからは見えないチップ直結の専用回路を使われています |
| 共有メモリ同期 | 手動バリア同期の待機遅延 | キャッシュ階層と連動したパイプライン | バリア同期を入れるたびにGPUがストールしていました |
| カーネル融合 | 静的な個別カーネル処理 | Q×K・Softmax・Vが完全インメモリ融合 | 中間のテンソル書き出しが一切発生しない構造です |
| 実装・保守コスト | 数百行の生シェーダー管理 | API呼び出し数行で完結 | 意地を張らず素直にMPSGraphを使うのが大正解でした |
表の数値が示す通り、MPSGraph SDPAの「11.8 ms」という速さは、Apple Silicon内部の専用行列演算ユニット(AMX)と、Q×K・Softmax・Vの乗算処理がメモリ上で完全に一体化されたカーネル融合によって実現されています。公開されているMetal Shading LanguageのAPIから自前でタイリングを組んでも、中間のSoftmax同期でキャッシュフラッシュが発生し、どうしても太刀打ちできませんでした。
4. 計測を歪める「2つの罠」:プロファイラ自身の遅延と熱ダレ
自前カーネルを諦めてMPSGraphに一本化した後、さらに頭を悩ませたのが「ベンチマーク数値のブレ」でした。
① プロファイラ自身が推論を遅くする罠(`H3_PROFILE=1`)
各処理の正確なミリ秒を測るため、h3.c内に H3_PROFILE=1 や --profile フラグを用意し、GPUタイムスタンプを記録していました。ところが、このプロファイラをオンにすると、なぜか全体の推論速度が15〜20%も低下する事態に陥りました。
原因を調べたところ、完了時刻を正確に取得するために同期処理(waitUntilCompleted)を挟んだことで、Metal本来の非同期パイプラインが止まり、GPUコアに無駄な待ち時間が発生していたことが分かりました。また、--profile の集計はMPSGraphが内部で動かす子コマンドバッファを拾いきれず、「表示上の数字は速いのに、実際のストップウォッチは遅い」というちぐはぐな現象が起きていました。
② 熱ダレによるタイムの激変
さらに厄介だったのが、MacBook Proの連続稼働による熱の影響です。まったく同じコード、同じパラメータ(512×288, 56フレーム)でベンチマークを回した際、以下の差が出ました。
- 1回目の実行(冷えた状態): 54.2秒
- 5回目の実行(連続高負荷後): 142.9秒(約2.6倍に遅延)
筐体に熱がたまると、OS側が自動的にGPUクロックを下げます。「最適化前」を冷えた状態で測り、「最適化後」を連続実行の温まった状態で測ってしまうと、実際には改善しているコードを「遅くなった」と勘違いして捨ててしまう危険がありました。
5. 試行錯誤から得られた3つの教訓
一連のチューニングを通じて得られた結論は次の3つです。
- アテンションの自作は避け、
MPSGraph SDPAに任せる
Appleがチップ設計とセットで最適化したカーネルには、生シェーダーでは勝てません。 - ベンチマークは「同一プロセス内の交互実行」で測る
プロセスを立ち上げ直すと熱状態が変わります。単一プロセス内で `Kernel A` ➔ インターバル ➔ `Kernel B` を切り替えて測定するテストハーネス(bench_dit.c)を使うことで、熱の影響を排除した正確な比較ができます。 - 最後はストップウォッチ(Wall-clock実測)で判断する
内部プロファイラの数値だけに頼らず、エンドユーザーが体感する実時間を基準にすることが最も確実です。
6. よくある疑問と本音(FAQ)
Q1. なぜ自前のMetalシェーダーはMPSGraphに勝てないのですか?
A1. Apple Siliconのチップ内部には、通常のMetal Shading Languageからは叩けない専用の行列演算ユニットがあり、MPSGraphはその回路を直接駆動できるためです。また、キャッシュ制御もシリコン世代ごとに専用チューニングされています。
Q2. 熱ダレを防ぐために、推論の合間に短い休憩(sleep)を入れるのは効果的ですか?
A2. 実際に検証してみましたが、5〜10秒程度の短い待機ではヒートシンクの熱は抜けず、全体の処理時間が延びるだけでした。クロックが落ちて安定した状態で比較するか、ファンを全開にして測るのが現実的です。
Q3. 現在のh3.cは、どれくらいの速度で動画が生成できていますか?
A3. MPSGraph SDPAとVideo VAEの384pxタイリングを組み合わせることで、解像度896×512・22フレーム(Steps 20)の生成が、M5 Max環境で約15〜20秒前後で安定して完了しています。
📚 MiniMax-H3 開発実践記シリーズ(関連記事)
- 第1弾(本記事): 【Metal最適化】自前Flash Attention大敗と熱ダレの落とし穴
- 第2弾:【GGUF移植の実践】h3.cに移植して踏み抜いた「確定バグ5選」とINT4量子化でLoRAが消滅する冷酷な真実 ➔
- 第3弾:【画質検証】なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuse(CR2)と層削減を全面禁止にした検証ログ ➔
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- ▶ 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠 (※現在の記事)
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
コメント