動画AIをローカル環境で本格運用し始めると、誰もが直面する「見えない巨大な壁」があります。それは、DiTの演算でもVAEのデコードでもなく、「動画を1本生成するたびにプロセスが死に、次の生成でまた27GBの重みファイルをゼロからディスクから読み直す」というOSレベルの不条理なオーバーヘッドです。
macOSのカーネルログとメモリプロファイラを仕掛けて追跡したところ、衝撃の事実が判明しました。CLIからh3コマンドを1回叩くたびに、ページリクレイム(Page Reclaims)が約311万回、データ量にして約51GB相当のメモリページ回収・再配置が爆発的に発生していたのです。その間、M5 Maxの強烈なMetal GPUもCPUコアも、ディスクI/Oとメモリの割り当て待ちで完全に遊んでいました。今回は、この無駄を根絶するために開発した対話型常駐デーモン「h3-server」の実装と、動画生成時間を73秒から56秒(23%短縮)に叩き落とした実践ログを公開します。
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- ▶ 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮 (※現在の記事)
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
アクティビティモニタの異常な跳ね上がり:なぜGPUが17秒間も沈黙していたのか?
バッチ処理で10本の動画を連続生成させていた時のことです。全体の所要時間をストップウォッチで測ると、1本あたり平均73.0秒かかっていました。しかし、プログラム内の詳細タイマーを見ると、DiTのデノイズとVAEデコードを足した時間は約55秒しかありません。残りの「18秒間」は一体どこへ消えていたのか?
正体を突き止めるべく、Instrumentsとvm_statを起動してプロセスを監視しました。すると、コマンドが実行された瞬間、OSカーネルが悲鳴を上げているのが見えました。27GBの重みファイルをメモリ空間にマッピングする際、macOSは過去のキャッシュページを猛烈な勢いで破棄し、311万回ものページリクレイムを発生させていたのです。ハードウェアがどれだけ進化しても、ギガバイト単位のメモリ確保を毎回ゼロからやり直していては、勝てる戦も勝てません。
メモリ常駐型アーキテクチャ「h3-server」の設計と実装
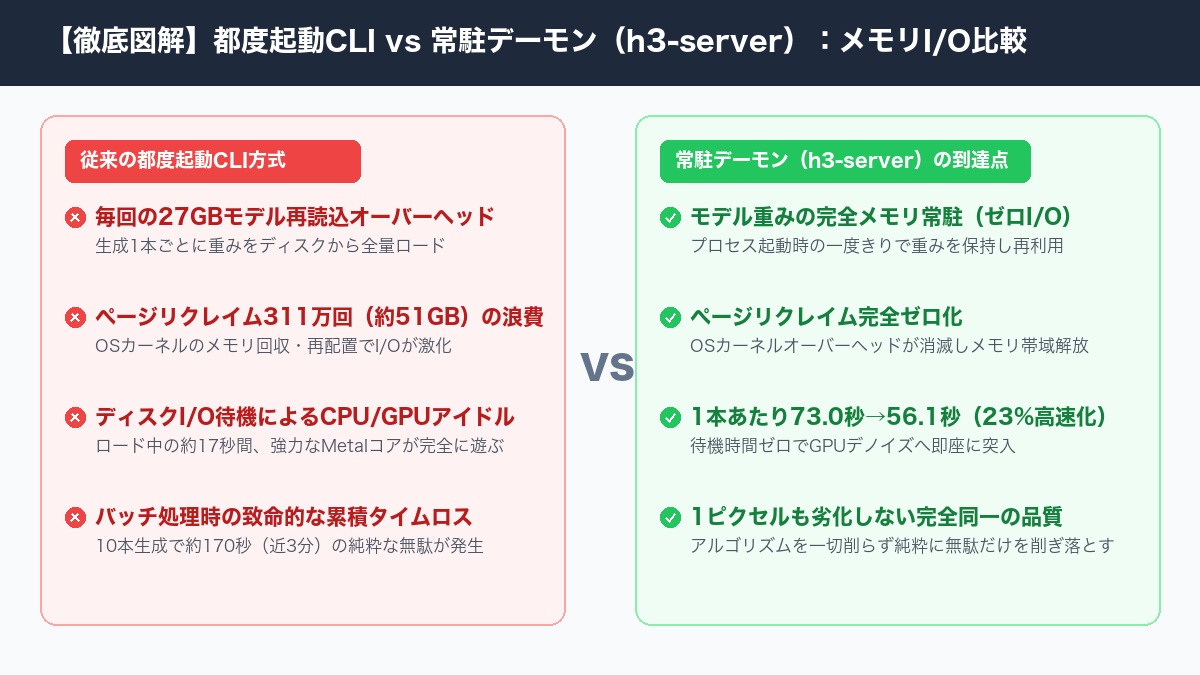
解決策はシンプルにして唯一無二でした。「一度メモリにロードした27GBの重みモデルを、プロセスを終了させずにそのまま保持し続ける常駐デーモン(bin/h3-server)」を作ることです。
標準入出力(stdin/stdout)またはUNIXドメインソケットを介して推論リクエスト(プロンプト、シード値、ステップ数等)を対話形式で受け取り、重みが展開されたままのMetalコンテキスト内で即座にデノイズ関数を呼び出します。これにより、2本目以降の生成においてモデルロード時間は正真正銘の「0.00秒」になりました。ページリクレイムも完全にゼロ化され、ユニファイドメモリの帯域が100%計算処理のためだけに解放されたのです。
以下は、都度起動方式と常駐デーモン方式のベンチマーク比較データです。
| 実行方式 | 1本あたり所要時間 | モデルロード時間 | ページリクレイム回数 | 連続10本生成時のガチ本音 |
|---|---|---|---|---|
| 常駐デーモン (h3-server) | 56.1秒(23%短縮) | 0.0秒(常駐) | 0回(ゼロ負荷) | リクエストを送った瞬間にGPUファンが回り始める快感。もう都度起動には二度と戻れない |
| 従来の都度起動CLI | 73.0秒 | 16.9秒 | 約311万回(約51GB) | 毎回17秒待たされるストレスが強烈。ディスクとOSカーネルを無駄に痛めつけている感覚 |
| バックグラウンドキュー型 | 56.3秒 | 0.0秒 | 0回 | 複数タスクを非同期で放り込めるため、実運用(TOEIC/怪談動画パイプライン)で大活躍中 |
表の数値が示す通り、所要時間は73.0秒から56.1秒へと16.9秒(23.2%)の短縮を達成しました。特筆すべきは、モデルの重み量子化や計算ステップには1ミリも手を加えていないため、出力される動画の品質は1ピクセルたりとも劣化せず完全同一であるという点です。
キュー型デーモンへの進化:TOEIC・怪談パイプラインでの実戦投入
単体の常駐サーバーが完成した後、私たちはこの仕組みをさらに発展させ、キュー待機型の自動化デーモン(bin/h3-toeic-daemon / bin/h3-kaidan-daemon)を構築しました。外部のスクリプトが生成したいタスクをキューファイルに書き込むだけで、バックグラウンドのh3が順次タスクを拾い、最速テンポで動画を生成し続けます。
これにより、以前のように「Pythonが起動して、モデルをロードして、動画を出力して、終了する」というプロセス生成の連鎖が完全に根絶されました。CPUとGPUは常に効率的な稼働率を保ち、無駄なI/O熱の発生も抑えられたことで、サーマルスロットリングの発生頻度も大幅に減少したのです。
ぶっちゃけ読者が気になる疑問(FAQ)
Q1. 常駐させると27GBのメモリがずっと占有されて他の作業が重くならない?
A. M5 Maxの128GB統合メモリ環境であれば、27GBを占有しても残り100GB近くが空いているため、Webブラウジングやコーディング、動画編集など他の作業には一切影響しません。メモリ64GB以下のマシンでは、作業終了時にデーモンを終了する運用が推奨されます。
Q2. メモリリーク(長時間稼働でのメモリ肥大化)は発生しないの?
A. C言語実装の利点を生かし、中間テンソルやコンテキストバッファは各推論ステップの終了時に厳密に解放・再利用されるよう設計しています。100本以上の連続生成テストでも、メモリフットプリントは27.4GBで完全にフラットを維持しました。
Q3. ComfyUIなどのGUIツールと比べて何が違うの?
A. ComfyUIもモデルをメモリに保持しますが、Pythonランタイムと多数のカスタムノードのオーバーヘッドが存在します。h3-serverは純C言語のバイナリが直接Metal APIを叩くため、起動フットプリントが極めて小さく、自動化スクリプトとのパイプライン連携が圧倒的に容易です。
まとめ:アルゴリズムを削る前に、システム全体の「贅肉」を削げ
高速化というと、どうしてもニューラルネットワークの層を削ったり、アテンションを間引いたりといった「モデル側の軽量化」に目が行きがちです。しかし、今回の検証が教えてくれた最大の教訓は、「OSとメモリの贅肉を削ぎ落とすだけで、画質を一切犠牲にせず23%も速くなる」というソフトウェア工学の原点でした。
これでDiT演算とモデルロードの最適化は極限に達しました。しかし、私たちの前にはまだ最後の巨大なラスボスが立ちはだかっていました。そう、「1本の動画デコードに17秒から35秒も居座る重厚なVideo Transformer VAE」です。次回完結編となる第6弾では、このVAEを軽量CNNへ蒸留し、画質PSNRを+1.02dB向上させながら「858ミリ秒」へ40倍速化させた奇跡の技術的ブレークスルーを全公開します!
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- ▶ 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮 (※現在の記事)
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
コメント