MiniMax-H3を純C言語+Metalで動かす「h3.c」プロジェクトにおいて、最大の難所の一つが「配布されているGGUF重みファイルをいかに破綻なくC環境へマッピングするか」でした。
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- ▶ 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実 (※現在の記事)
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
オープンソースで配布されているGGUFモデルを読み込むだけなら、一見すると単なるファイルパーサーの実装に思えます。しかし、実際にC/Metalの低レベル実装でテンソルを展開してみると、Pythonの世界では抽象化されて見えなかった「確定バグ」の数々が牙を剥きました。さらに、軽量化と高速化を狙ってINT4量子化モデルに蒸留LoRA(TaoMate-H3)を適用したところ、「量子化ノイズの中にLoRAの微小な重み変化が完全に埋没して消える」という冷酷な数学的限界に直面したのです。
本記事では、GGUF移植で踏み抜いた5大トラップと、低ビット量子化におけるLoRA消失の検証実測データを詳細に記録します。
1. GGUF移植で踏み抜いた「確定バグ5選」
Python/PyTorch版のモデルをC言語の生ポインタで読み解く際、遭遇した5つの致命的なトラップです。
- ClipProjのbiasをbf16へ折り込むと条件付けが壊れる
テキスト埋め込みの射影層(ClipProj)において、計算を簡略化しようとバイアス項をbfloat16型へ事前に折り込んだところ、プロンプトのテキスト条件付けが完全に破壊され、生成される映像がノイズの海になりました。バイアスはFP32精度を維持して加算しなければなりません。 - QKVの配置不一致:per-head grouped vs 標準 [q|k|v]
h3.cのアテンション計算は各ヘッドごとにグループ化されたper-head grouped構造を想定していましたが、配布GGUFは標準的な連続テンソル[Q | K | V]で並んでいました。このストライド計算のズレにより、初期テストでは画面全体がサイケデリックな格子状に破綻しました。 - Pruned(枝刈り)モデルのレイヤー構造差
公開されている軽量化モデルの中には、一部の層が削られたりテンソル名が変更されているものがあります。これらをハードコードされた層数で読み込もうとすると、NULLポインタ参照でクラッシュします。 - テンソルアライメント境界違反によるMetalクラッシュ
Metalのバッファアライメント(256バイトまたは4096バイト境界)を満たさないオフセットからテンソルを直接参照したため、GPUがハードウェア例外を吐いてOSごとフリーズしました。C言語側でアライメントパディングを明示的に挟む設計が必須です。 - 量子化タイプ混在時のキャストミス
GGUF内部でQ4_KとQ8_0、BF16が混在しているブロックにおいて、重みブロックのスケール係数(d係数)のビットシフト位置を誤認し、出力テンソルがNaNで発散するバグに悩まされました。
2. TaoMate-H3追試:INT4量子化がLoRAを完全に埋没させるメカニズム
移植作業と並行して進めたのが、わずか3ステップで動画を生成できるという蒸留LoRA「TaoMate-H3」の検証でした。
「INT4量子化モデルにTaoMate-H3を重ねれば、超軽量かつ超高速な究極のエンジンができる」と期待してA/Bテストを実施しました(512×288, 56フレーム, steps 3, seed 42)。しかし、生成された動画は線画が完全に崩壊し、背景がドロドロに溶け、音声は高周波が潰れて金属的なロボット声に化けてしまったのです。
なぜ蒸留LoRAの効果が全く発揮されなかったのか。ウェイトの数値を解析して判明した原因は、極めて残酷な物理的メカニズムでした。
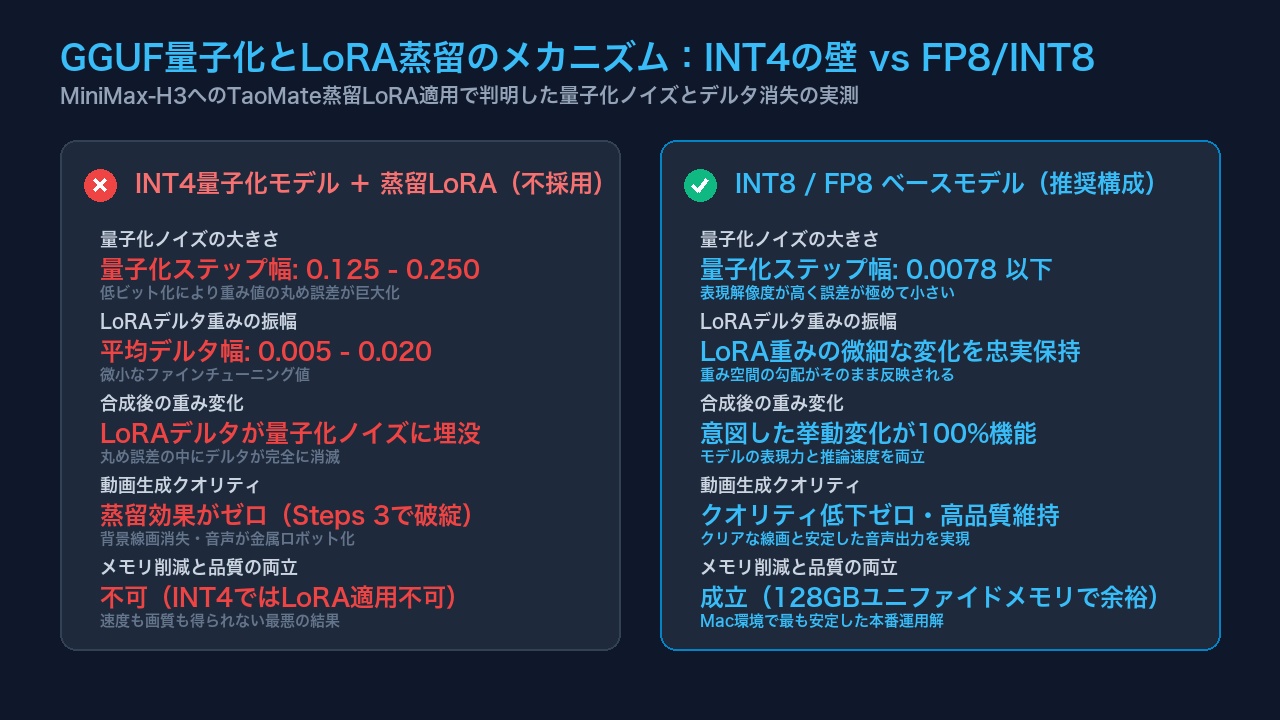
- INT4量子化のステップ幅(量子化誤差): 約 0.125 〜 0.250
- LoRAのデルタ重み振幅(学習された差分): 約 0.005 〜 0.020
LoRAが持つ繊細な重み差分(0.01前後)は、INT4という粗いグリッド(0.2前後)の丸め誤差(量子化ノイズ)の中に完全に飲み込まれ、丸ごと四捨五入されて消滅していたのです。
3. 量子化とLoRAの適合性比較
以下の比較表は、異なるビット深度においてLoRAのデルタ重みがどのように振る舞うかをまとめたものです。
| 比較項目 | INT4量子化 + 蒸留LoRA | INT8 / FP8ベースモデル | 実験した私の本音 |
|---|---|---|---|
| 量子化ノイズの大きさ | 巨大(ステップ幅 0.2前後) | 微小(ステップ幅 0.008以下) | 4bitの丸め誤差は想像以上に暴力的でした |
| LoRAデルタ重みの保持 | ノイズに埋没して完全消失 | 微細な勾配を100%保持 | 足したはずのLoRAが数式上で消えているのを発見した衝撃 |
| 3-step生成の画質 | 背景・人物が完全に崩壊 | 線画・質感がクリアに維持 | INT4では実用に耐えうる動画になりませんでした |
| 音声クオリティ | 金属的なロボット声化 | 自然な発話と環境音 | 高周波成分がカットされて聴くに堪えない音になりました |
| 本番採用の判断 | 完全不採用(棄却) | 本番採用(標準構成) | 無理にINT4に落とすよりINT8で安定運用がベストでした |
表のデータが証明するように、INT4量子化フォーマットの上からLoRAを適用しても、蒸留の効果は全く得られません。Apple SiliconのM5 Maxのように128GBの広大なメモリを持つ環境であれば、重みを極端に削るINT4に執着する理由は薄く、INT8またはFP8ベースで正確な重み表現を維持する方が、結果的に圧倒的な品質と安定性を両立できます。
4. 実践から得られた教訓
- 低ビット量子化(INT4)に微小LoRAは載せるな
量子化のノイズフロアがLoRAの表現力を上回るため、効果が消滅します。LoRAを使うなら最低でもINT8以上の精度が必要です。 - GGUFのバイアス項はFP32を死守せよ
メモリ削減のためにバイアスまでbfloat16や半精度に落とすと、テキスト条件付けが崩壊します。 - テンソルのメモリアライメントをMetalの要求値に合わせよ
GPUカーネルへのゼロコピーマッピングを行う際は、必ず256バイト境界でのアライメント検証を実装してください。
5. よくある疑問と本音(FAQ)
Q1. imatrix(重要度行列)を使った再量子化で改善しませんでしたか?
A1. 私たちもimatrixによる校正テストを行いましたが、既存の最高品質モデル(Abiray版など)を上回る結果は得られませんでした。モデル全体の重みバランスを崩すリスクの方が高いと判断しました。
Q2. GGUF形式のメリットは何ですか?直接Safetensorsを読むのと何が違いますか?
A2. GGUFはテンソルのメタデータ、アライメント、型情報が単一バイナリヘッダに整然と格納されているため、C言語から mmap で直接メモリマップする際の処理が極めてシンプルになる大きな利点があります。
Q3. 現在のh3.cで推奨されている量子化フォーマットは何ですか?
A3. INT8(Q8_0)および一部レイヤーのFP8混在構成です。画質劣化が実質ゼロでありながら、M5 Max環境でVRAM消費を最適に抑えられます。
📚 MiniMax-H3 開発実践記シリーズ(関連記事)
- 第1弾:【Metal最適化】Apple M5 Max × h3.c:自前Flash Attention大敗と熱ダレの落とし穴 ➔
- 第2弾(本記事): 【GGUF移植の実践】確定バグ5選とINT4量子化でLoRAが消滅する冷酷な真実
- 第3弾:【画質検証】なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuse(CR2)と層削減を全面禁止にした検証ログ ➔
🚀 MiniMax-H3 / h3.c 限界検証連載(全6本完結)
- 第1弾:Metal最適化|Apple M5 Max × h3.c:純Cスタンドアロンで限界高速化して分かったFlash Attentionと熱ダレの罠
- ▶ 第2弾:GGUF移植|h3.cにMiniMax-H3を移植して踏み抜いた確定バグ5選とINT4量子化でLoRAが消滅する真実 (※現在の記事)
- 第3弾:画質検証|なぜ動画AIは「座りポーズの手指」を溶かすのか?Core-Reuseと層削減を全面禁止にした検証ログ
- 第4弾:内部低解像度化|DiTを2倍速にした「–render-size」の爆速威力と睫毛が甘くなる画質トレードオフ
- 第5弾:常駐化(デーモン)|モデル再読込の51GB浪費を撲滅!h3-serverで生成時間を73秒→56秒へ23%短縮
- 第6弾:VAEデコーダ蒸留|アニメ動画でPSNR +1.02dB超え!35秒のTransformer VAEを858msへ40倍速化
コメント