「GPT-6 Astraがキャパオーバーで最上位プランを停止」「主要AIサービスのAPI利用規約が改定され、利用料金が先月の3倍に跳ね上がった」「機密コードを外部クラウドに送信することが社内コンプライアンスで全面禁止に」……。2026年9月、クラウドAIの急激な進化の裏側で、世界中のスタートアップや凄腕エンジニアたちの間で急速に広がっているムーブメントがあります。それが、「巨大テックのクラウド依存から脱却し、手元のハードウェアで自律稼働させるローカルLLMへの大回帰」です。
私自身、毎月数十万円に膨れ上がるAPI利用料の請求書と、クラウド側の障害で開発が数時間ストップするリスクに頭を抱え続けてきました。外部のサーバーが落ちれば自社のプロダクトも止まる。そんな「他人のプラットフォームに生殺与奪の権を握られた状態」に強い危機感を抱き、手元のMac StudioやローカルGPUワークステーションに量子化モデル(Llama 3.3やMistral、自律画像生成H3など)を配備した瞬間、目の前がパーッと開けるような強烈な全能感を手に入れました。
事実として何が起きているのか:軽量化技術とユニファイドメモリの爆発的進化
客観的な技術的ファクトを整理しましょう。数年前まで「ローカルでAIを動かす」といえば、何百万円もする巨大なサーバーラックと莫大な電気代が必要で、出力される回答もクラウドに遠く及ばないオモチャのような性能でした。
しかし2026年の現在、「4bit/3bit量子化技術(AWQ/GGUF)の極限進化」と、Apple Siliconや最新GPUが搭載する広帯域ユニファイドメモリ(最大192GB〜512GB)の普及により、70B(700億パラメータ)クラスの超高性能モデルが、机の上のPCで1秒間に40トークン以上の猛スピードで滑らかに動作する環境が完全に整ったのです。
メガクラウド独占型 vs ローカル自立型:エンジニア視点のガチ比較
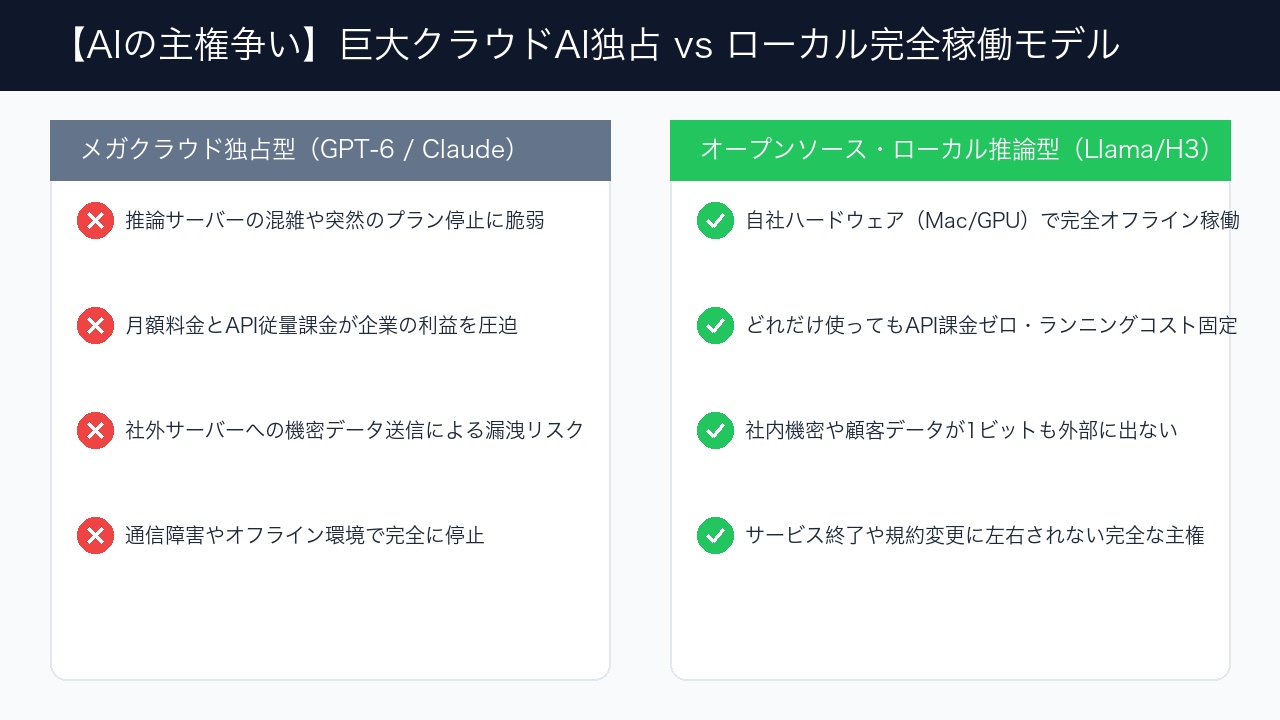
OpenAIやAnthropicなどの「クラウドAPIに依存する開発体制」と、自前の「ローカルLLM完結体制」におけるコストと自由度を徹底比較しました。
以下の比較表は、月額コスト、セキュリティ、ネットワーク遮断時の稼働性を整理したものです。
| 運用項目 | メガクラウド独占型(GPT/Claude) | ローカル完全稼働型(自立モデル) | 両方を使い倒す筆者のガチ本音 |
|---|---|---|---|
| ランニングコスト(月額) | 使った分だけ課金(月数万円〜数十万円) | ハード購入後は電気代のみ(月数千円) | トークン残量を気にせず無限に回せる快感 |
| 機密データ・プライバシー | 社外クラウドへ送信(規約リスク) | 1ビットもPC外に出ない(漏洩リスクゼロ) | 社内機密コードや個人情報を平気で食わせられる |
| 耐障害性・オフライン | 通信障害やAPI制限で業務が全停止 | Wi-Fi遮断・飛行機内でも100%稼働 | 山奥のキャンプ場でもAIコーディングが可能 |
| 検閲・利用制限ポリシー | プラットフォーム側の都合で回答拒否 | 完全アンセンサードで自由な検証が可能 | 「倫理的に答えられません」のお説教から解放 |
表中の比較データが如実に示している通り、最大の価値は「自社のデータと事業の主権を自分たちの手元に取り戻せること」です。顧客情報、財務データ、独自アルゴリズムなど、企業にとって生命線となるデータを外部クラウドのAPIに流し続けることは、現代のセキュリティ基準において致命的なリスクを伴います。手元のハードウェアで推論を完結させられる体制を持つことは、単なるコスト削減を超えた「企業の究極の事業継続性(BCP)」に他なりません。
自分のマシンで知能を飼い慣らす時代の幕開け
AIの歴史は、中央集権(メインフレーム)と分散(パーソナルコンピュータ)の振り子を繰り返してきました。クラウドの巨大データセンターに知能が集約された時代を経て、いま振り子は再び「個人のデスク」へと力強く戻ってきています。
インターネットが繋がっていなくても、月額の課金が切れても、あなたのPCの中で休むことなく働き続ける従順で優秀な知能。巨大プラットフォーマーに搾取される側から、自前のハードウェアで知能を自給自足する側へ。この静かなる技術革命に、あなたも一歩踏み出してみませんか。
ぶっちゃけFAQ:ローカルLLMに関する気になる疑問
Q1. 一般的なノートPCでもローカルLLMは動きますか?
A. 8B(80億パラメータ)クラスならM1〜M3のMacBook(メモリ16GB以上)で爆速で動きます。日常の文章要約、コード生成、翻訳であれば、驚くほど軽快に動作します。
Q2. 導入は難しくないですか?コマンド操作が必要?
A. 「Ollama」や「LM Studio」を使えばワンクリックで導入できます。複雑なPython環境構築やターミナルコマンドを一切使わず、通常のデスクトップアプリのようにインストールして数分で使い始められます。
Q3. クラウドAIはもう全く使わなくて良いのですか?
A. ハイブリッド運用が最強です。日常業務や機密タスクの8割をローカルで高速・無料処理し、超難解な推論や最新情報の検索が必要な2割だけクラウドAPIを呼び出すのが最も賢い設計です。
コメント